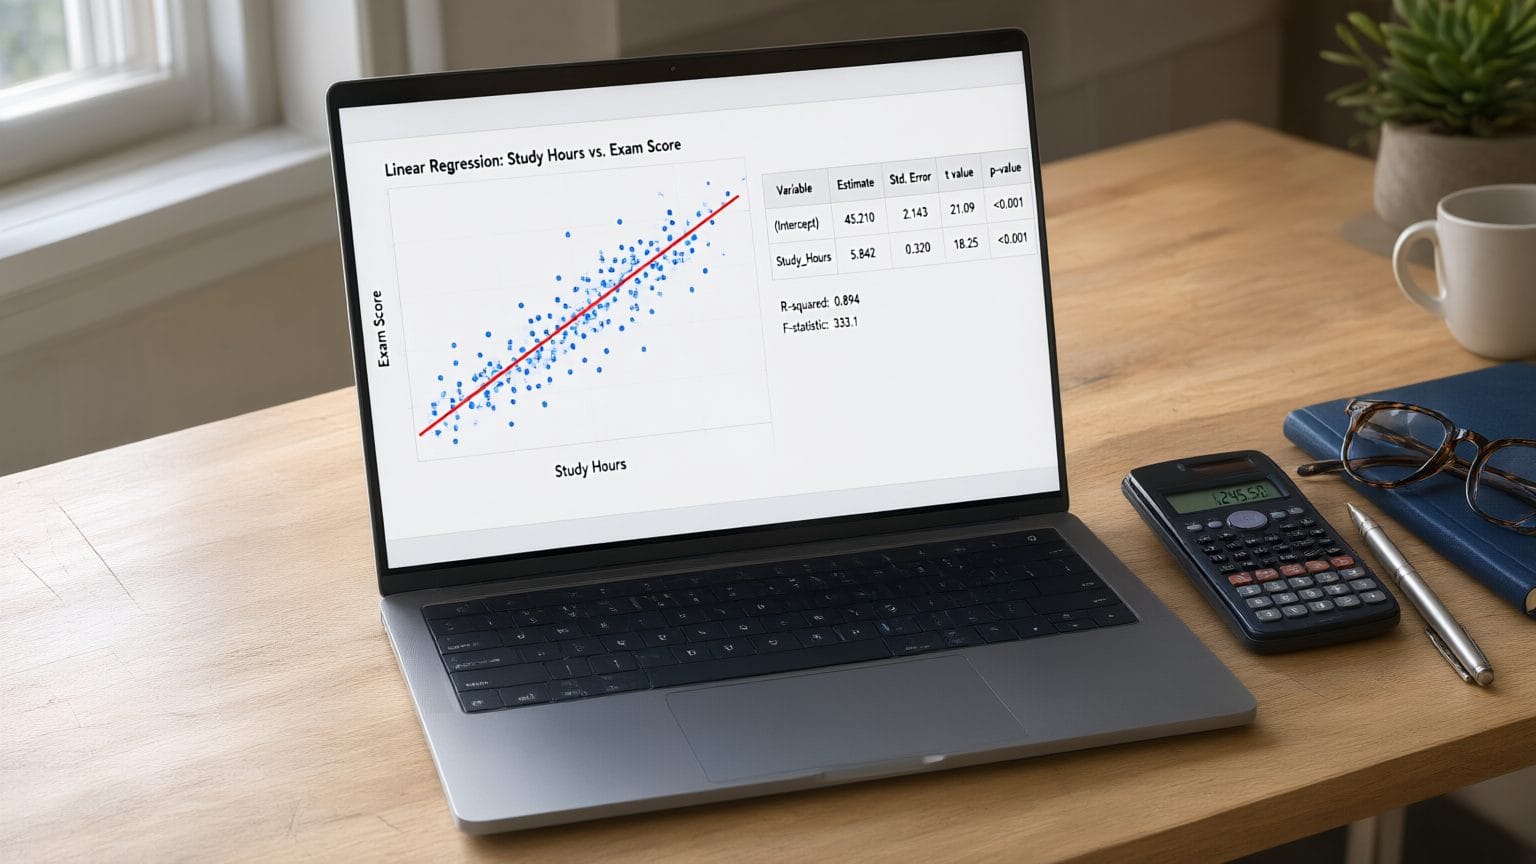
Una regresión lineal en jamovi es un análisis que se realiza para modelar la relación entre una variable dependiente y una o varias variables independientes. Para ejecutarla, se accede al menú Analyses > Regression > Linear Regression.
Pasos para realizar una regresión lineal en jamovi
El procedimiento es el mismo tanto para la regresión lineal simple como para la múltiple. La diferencia radica en el número de variables predictoras que se añaden al modelo.
- Abre tu conjunto de datos en jamovi.
- En la barra superior, haz clic en Analyses.
- Selecciona Regression y luego Linear Regression.
- En el panel que aparece a la derecha, arrastra la variable que quieres predecir al campo Dependent Variable.
- Arrastra una o más variables predictoras al campo Covariates (para variables continuas) o Factors (para variables categóricas).
- Haz clic en las pestañas de opciones para configurar los resultados que necesitas.
Opciones y estadísticos útiles en la ventana de regresión
Jamovi ofrece varias pestañas para personalizar el análisis. Estas son las más relevantes.
Model Fit
Aquí se obtienen las medidas clave para evaluar el modelo global.
- R²: Indica el porcentaje de la varianza de la variable dependiente que explica el modelo. Un valor más alto significa un mejor ajuste.
- R² ajustado: Es una versión corregida de R² que penaliza la inclusión de predictores irrelevantes. Es más útil en regresión múltiple para comparar modelos con diferente número de variables.
- Prueba F: Evalúa si el modelo en su conjunto es estadísticamente significativo (es decir, si al menos un predictor tiene una relación lineal con la variable dependiente). Se observa el valor p asociado.
Coefficients
Esta es la tabla central, donde se muestran los coeficientes de regresión para cada predictor.
- Estimate: Es el valor del coeficiente (b). Indica cuánto cambia la variable dependiente por cada unidad de cambio en el predictor, manteniendo constantes las demás variables.
- Std. Error: El error estándar del coeficiente, una medida de su precisión.
- t: El estadístico t para la prueba de significancia individual de cada coeficiente.
- p: El valor p asociado al estadístico t. Valores inferiores a 0.05 suelen indicar que el coeficiente es significativamente distinto de cero.
En esta pestaña también se pueden activar opciones como:
- Coefficient plot: Muestra un gráfico con los intervalos de confianza de cada coeficiente.
- Standardized estimates: Proporciona los coeficientes estandarizados (beta), que permiten comparar la importancia relativa de los predictores cuando están en escalas diferentes.
- Confidence intervals: Calcula los intervalos de confianza (generalmente al 95%) para cada coeficiente.
- VIF (Factor de Inflación de la Varianza): Es un indicador de multicolinealidad. Valores superiores a 5 o 10 sugieren un problema de alta correlación entre predictores.
Assumption Checks
Jamovi incluye comprobaciones automáticas de algunos supuestos clave de la regresión lineal.
- Normality: Realiza pruebas (Shapiro-Wilk) sobre la normalidad de los residuos del modelo.
- Q-Q plot: Genera un gráfico cuantil-cuantil para evaluar visualmente la normalidad de los residuos.
- Durbin-Watson: Prueba la independencia de los residuos, útil para detectar autocorrelación en datos de series temporales. Un valor cercano a 2 indica no autocorrelación.
Cómo interpretar los resultados y las tablas
La interpretación se realiza en dos niveles: el modelo global y los coeficientes individuales.
Interpretación del modelo global
Primero se mira la tabla de Model Fit. Si el valor p de la prueba F es menor que el nivel de significancia elegido (por ejemplo, 0.05), se concluye que el modelo es significativo. Luego, se observa el R² para saber cuánta varianza explica. Por ejemplo, un R² de 0.35 significa que el modelo explica el 35% de la variabilidad de la variable dependiente.
Interpretación de los coeficientes
Se analiza la tabla Coefficients. Para una regresión lineal simple con ecuación Y = a + bX:
- El intercepto (a) es el valor predicho de Y cuando X es igual a cero. Su interpretación práctica depende de si el valor cero tiene sentido para el predictor.
- La pendiente (b) indica el cambio esperado en Y por cada aumento de una unidad en X. Si b es positivo, la relación es directa; si es negativo, es inversa.
En regresión múltiple, la interpretación es similar, pero añadiendo «manteniendo constantes las demás variables del modelo». Por ejemplo: «Por cada año adicional de experiencia (X1), el salario (Y) aumenta en b1 unidades, manteniendo constante el nivel educativo (X2)».
Ejemplo ilustrativo (números coherentes)
Imagina un estudio que investiga si las horas de estudio semanales (predictor) predicen la nota en un examen de 0 a 10 (variable dependiente). Tras ejecutar el análisis en jamovi, se obtienen estos valores:
| B | Error estándar | t | p | |
|---|---|---|---|---|
| Intercepto | 3,50 | 0,50 | 7,00 | < 0,001 |
| Horas de estudio | 0,80 | 0,20 | 4,00 | < 0,001 |
El modelo es estadísticamente significativo, F(1, 98) = 16,00, p < 0,001, y explica el 60% de la variación en las notas (R² = 0,60). La ecuación resultante es: Nota esperada = 3,50 + 0,80 × (horas de estudio). Por cada hora adicional de estudio semanal, se espera un aumento de 0,80 puntos en la nota del examen.
Regresión lineal simple frente a múltiple en jamovi
La diferencia operativa en jamovi es mínima. Para una regresión simple, solo se arrastra una variable al campo Covariates. Para una múltiple, se arrastran dos o más. La interpretación se vuelve más cuidadosa en la múltiple, ya que hay que considerar la posible interacción entre predictores y la multicolinealidad. Es recomendable activar la opción VIF en estos casos.
Cómo redactar los resultados en un TFG o tesis (formato APA)
Para informar de los resultados, sigue una estructura clara:
- Introducción al análisis: «Se realizó un análisis de regresión lineal [simple/múltiple] para evaluar si [variable(s) predictora(s)] predecían [variable dependiente]».
- Presentación de los resultados globales: «El modelo resultó significativo, F(grados de libertad del modelo, grados de libertad del error) = [valor F], p = [valor p]. El modelo explicó un [R² en porcentaje]% de la varianza (R² ajustado = [valor]).»
- Presentación de los coeficientes: Usa una tabla con los coeficientes no estandarizados (B), sus errores estándar, los coeficientes estandarizados (β si los usas), y los valores t y p. En el texto, destaca los significativos: «Como se muestra en la Tabla X, la variable [nombre del predictor] mostró una asociación positiva significativa con [variable dependiente] (B = [valor], p = [valor]).»
- Interpretación: «Estos resultados indican que, manteniendo constantes las demás variables, por cada unidad de aumento en [predictor], se espera un aumento/disminución de [valor del coeficiente B] unidades en [variable dependiente].»
Un ejemplo de párrafo para el capítulo de resultados sería:
Se ejecutó un análisis de regresión lineal simple para evaluar si las horas de estudio semanales predecían la nota obtenida en el examen final. El modelo fue estadísticamente significativo, F(1, 98) = 16,00, p < 0,001, y explicó el 60% de la varianza (R² = 0,60). El coeficiente de regresión indicó que por cada hora adicional de estudio, la nota esperada aumentaba 0,80 puntos (B = 0,80; IC 95% [0,40; 1,20]; p < 0,001).
Errores típicos al usar regresión lineal en jamovi
- No comprobar supuestos: Asumir que los resultados son válidos sin revisar la normalidad de los residuos, la homocedasticidad o la multicolinealidad.
- Confundir significación con importancia: Un coeficiente puede ser estadísticamente significativo (p pequeño) pero tener un valor tan bajo que carezca de relevancia práctica.
- Interpretar correlación como causalidad: La regresión muestra asociación, no prueba que un cambio en X cause un cambio en Y.
- Ignorar la multicolinealidad: En regresión múltiple, incluir predictores muy correlacionados entre sí (alto VIF) infla los errores estándar y hace inestables los coeficientes.
- No reportar el R² ajustado en modelos múltiples: El R² simple siempre aumenta al añadir variables, aunque no sean útiles. El R² ajustado es una medida más honesta.
- Olvidar comprobar el tamaño de la muestra: Una regresión con pocos casos por predictor produce coeficientes poco fiables. Una regla orientativa es tener al menos 10-15 casos por predictor.
Para profundizar en la teoría detrás del análisis, puedes consultar nuestra calculadora y guía de regresión lineal y la calculadora de correlación de Pearson.
Preguntas frecuentes sobre regresión lineal en jamovi
¿Qué hago si mis residuos no siguen una distribución normal?
Puedes intentar transformar la variable dependiente (usando logaritmo, raíz cuadrada, etc.) o considerar métodos de regresión robustos. En algunos casos, con muestras grandes, la regresión lineal puede ser tolerante a ciertas desviaciones de la normalidad.
¿Cuándo debo usar coeficientes estandarizados (beta)?
Son útiles cuando quieres comparar la fuerza relativa de diferentes predictores que están medidos en unidades distintas (por ejemplo, edad en años e ingreso en euros). Un beta más alto indica una mayor contribución relativa al modelo.
¿Cómo sé si tengo un problema de multicolinealidad?
Activa la opción VIF en la pestaña Coefficients. Si algún Factor de Inflación de la Varianza es mayor que 5 (o 10, dependiendo de la rigurosidad), hay indicios de multicolinealidad. Una solución puede ser eliminar una de las variables altamente correlacionadas.
¿Puedo hacer una regresión con variables categóricas como predictores?
Sí. Jamovi las maneja automáticamente si las arrastras al campo Factors en lugar de a Covariates. El software creará variables dummy (variables ficticias) por defecto, usando una categoría como referencia.
¿Qué significa el valor Durbin-Watson y cuándo es relevante?
Esta prueba es relevante principalmente cuando los datos están ordenados en el tiempo (series temporales). Un valor cercano a 2 sugiere que no hay autocorrelación entre los residuos. Valores significativamente menores o mayores pueden indicar autocorrelación positiva o negativa, respectivamente.
¿Jamovi realiza automáticamente el gráfico de dispersión para una regresión simple?
No de forma automática dentro del módulo de regresión. Para crear un gráfico de dispersión con la línea de regresión, debes ir a Analyses > Exploration > Scatterplot y definir las variables. Es una buena práctica hacerlo para visualizar la relación antes del análisis.
Para seguir aprendiendo sobre este software gratuito, visita nuestra página con más guías de jamovi.